1. 배경
GC를 공부하다 문득 한 가지 의문이 생겼다
GC는 메모리 단편화를 해결하기 위해 Compaction 과정을 수행하는데,
" OS는 Paging으로 단편화를 해결했는데 JVM은 왜 Compaction 방식을 택했는가? "
이 질문에서부터 고민이 시작됐다
2. GC의 출발점 - Tracing GC
JVM은 Reference Counting이 아니라 Tracing GC를 사용한다
이유는 간단하다
참조의 갯수를 세는 Reference Counting의 경우, 참조가 0일 때 할당을 해제하는데
순환 참조가 발생한 경우 서로를 참조하고 있어 로직적으로 할당이 해제되지 않는다
때문에 JVM은 안정적인 할당 해제를 위해 Root Space부터 객체 그래프를 따라 객체를 탐색하는 Tracing GC를 사용한다
3. JVM의 메모리 할당 방식
JVM Heap은 기본적으로 연속된 공간 할당(Contiguous Allocation)을 기준으로 관리된다
객체를 생성하면 JVM은 내부적으로 마지막 할당 위치를 가리키는 포인터를 유지하는 Bump Pointer 방식을 사용한다
이를 통해 현재 가용 영역의 끝에 객체를 순차적으로 할당한다
이 방식은 단순히 포인터를 증가시키는 것만으로 할당이 가능해 매우 빠른 할당이 가능하다
하지만 여기서 한 가지 의문이 생겼다
OS는 Paging을 통해 메모리를 비연속적으로 관리하는데, JVM은 왜 여전히 연속된 구조를 유지하는가?
또한 GC 과정에서 STW(Stop-The-World)가 발생하는데, 특히 Compaction은 비교적 큰 비용을 유발하는 작업이다
그렇다면 Paging과 같은 방식으로 메모리를 관리하면 이러한 비용을 줄일 수 있지 않을까?
4. JVM이 Paging을 선택하지 않은 이유
JVM은 메모리를 Page 단위가 아니라 Object 단위로 관리한다
이 차이는 단순한 구현 방식의 차이가 아니라, GC의 동작 방식과 성능에 직접적인 영향을 준다
Tracing GC는 객체 그래프를 따라가며 메모리를 탐색한다
이 과정에서 JVM은 다음과 같은 작업을 반복한다
- 객체의 주소를 읽는다
- 내부 참조를 따라 다음 객체를 찾는다
- 해당 객체를 다시 읽는다
이러한 접근 방식을 Pointer Chasing이라고 한다
여기서 중요한 점은, 이 작업이 단순한 그래프 탐색이 아니라는 것이다
객체가 메모리 상에 분산되어 있을 경우
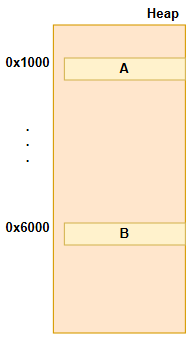
각 접근마다 전혀 다른 위치의 메모리를 읽게 된다
이로 인해 CPU cache miss 증가, TLB miss 증가가 발생하며,
메모리 접근 비용이 급격히 증가하게 된다
즉, 객체가 분산된 구조는 GC 성능에 치명적인 영향을 준다
한편, 객체 단위로 Paging과 유사한 구조를 유저 레벨에서 구현하는 것도 이론적으로는 가능하다
그러나 이 경우 주소 변화가 이중으로 발생하고, 하드웨어 TLB 및 cache 최적화를 활용할 수 없다
또한 가변 크기의 객체 특성상 메모리 효율 또한 떨어진다
결과적으로 이러한 방식은 오히려 성능 저하를 유발하게 된다
따라서 JVM은 Paging과 같은 비연속적인 구조를 선택하기보다는,
객체를 가능한 한 연속적으로 배치하는 방식을 택한다
5. 성능의 본질 - CPU Cache
CPU는 메모리를 1B 단위로 읽지 않고, Cache-line(보통 64B) 단위로 데이터를 가져온다
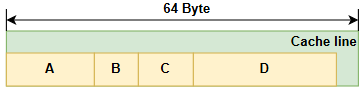
만약 그림과 같이 객체가 연속으로 배치되어 있다면, A를 읽는 순간 B와 C, D도 함께 cache에 올라온다
이 경우 이후 접근은 cache hit로 매우 빠르게 처리된다
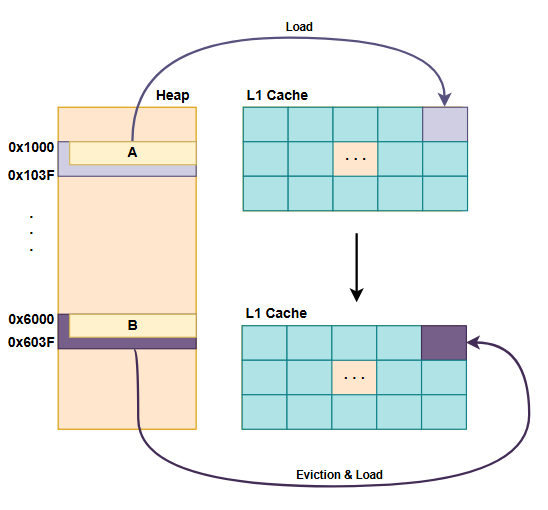
반대로 객체가 분산되어 있다면 각 접근마다 새로운 Cache-line을 가져와야하고,
cache miss가 발생하게 되며, 같은 슬롯에 배치될 경우 그림과 같이 eviction이 일어날 수 있다
이 차이는 GC의 성능에 직접적인 영향을 준다
6. Compaction의 역할과 이점
만약 접근하는 객체들이 서로 다른 Page에 존재한다면 접근 위치가 항상 달라지며, TLB entry가 계속 교체된다
즉, 객체가 분산되어 있을 경우 cache miss와 TLB miss의 두 가지 문제가 동시에 발생한다
그래서 Compaction이 등장한다
Compaction은 단순히 파편화를 방지하는 것에 그치지 않는다
GC 과정에서 살아남은 객체들을 새로운 공간으로 복사하며 앞쪽부터 연속적으로 채운다
이때 JVM이 직접 Page를 재배치하는 것은 아니지만,
객체들이 연속된 가상 주소 공간에 다시 할당되면서 결과적으로 동일한 Page에 위치할 가능성이 높아진다
즉, Compaction은 Page 자체를 다루는 작업이라기보다,
연속된 메모리 접근 패턴을 만들도록 객체를 다시 배치하는 과정에 가깝다
그 결과 살아있는 객체들이 한 영역에 모이게 되고,
메모리 접근은 Random Access에서 Sequential Access에 가까워진다
이는 Cache-line 단위 locality를 높이고,
동시에 동일한 Page 내 접근 비율도 높여 TLB 효율 향상에도 기여한다
7. Locality를 위한 또 다른 접근 - Huge Page
한편, 이러한 접근 패턴 최적화는 OS 수준에서도 일부 동일한 방향으로 나타난다
지금까지 설명해온 Compaction의 성능 향상 요소는
- 동일한 Page 내 접근 비율 증가를 통한 TLB miss 감소
- Cache-line 단위 locality 증가를 통한 Cache hit rate 향상
가 있을 수 있다
그렇다면 Page의 자체를 키워 같은 효과를 낼 수 없을까?
실제로 JVM에서는 -XX:+UseLargePages 를 통해 Huge Page를 활성화할 수 있고,
Linux에서는 /proc/sys/vm/nr_hugepages 에서 Huge Page 크기를 설정할 수 있다
하지만 Huge Page 사용에도 부작용이 존재한다
KAIST 논문에 따르면 아래와 같이 이야기한다
On the contrary, the allocation overhead of huge pages can be bigger than that of base pages since allocating a huge page demands 512 adjacent free base pages. In addition, it has a potential to waste memory when they are used sparsely or to amplify I/Os for swapping.
The fragmentation degree plays a key role on performance of the huge page technique. (출처)
즉, Huge Page 할당은 Page 할당 오버헤드가 기본 페이지보다 클 수 있으며,
메모리 파편화 정도에 따라 성능이 크게 영향을 받는다고 한다
결국 GC의 Compaction과 Huge Page는 서로 다른 계층에서 동작하지만,
모두 메모리 locality를 개선하기 위한 접근이라는 점에서 같은 방향을 바라보고 있다
'탐구일지 > Java' 카테고리의 다른 글
| G1 GC는 왜 기본 GC가 되었을까? (0) | 2026.04.24 |
|---|---|
| JVM GC는 어떻게 발전해왔는가? (0) | 2026.04.22 |
| JVM은 어떻게 플랫폼 독립성과 성능을 동시에 잡았을까? (2) | 2026.03.26 |
| 영속성 컨텍스트(Persistence Context)의 이해와 활용 (2) (0) | 2026.01.25 |
| 영속성 컨텍스트(Persistence Context)의 이해와 활용 (1) (0) | 2026.01.20 |


