7. 영속성 컨텍스트에 Entity가 등록되는 시점
이전 장에서 영속성 컨텍스트에 Entity가 Select 시에 추가된다고 하였다
하지만 이는 반만 맞는 이야기이다
조금 더 정확히 이야기하면,
영속성 컨텍스트에 추가되는 시점은 JPA가 Entity 인스턴스를 생성하여 반환하는 시점이다
단순히 보면 같은 이야기 아닌가 싶을 수도 있지만,
JPQL(Java Persistence Query Language)이나 QueryDSL을 사용해 본 개발자라면 조금 더 이해가 빠를지도 모르겠다
# 테스트 06. 쿼리별 영속성 컨텍스트 상태
@Repository
@RequiredArgsConstructor
public class TempQueryDslRepositoryImpl implements TempQueryDslRepository {
    private final JPAQueryFactory jpaQueryFactory;

    @Override
    public List<Long> getIdList() {
        return jpaQueryFactory.select(temp.id)
                .from(temp)
                .fetch();
    }

    @Override
    public List<Temp> getTempList() {
        return jpaQueryFactory.selectFrom(temp)
                .fetch();
    }
}
QueryDSL을 이용하여 ID 목록을 받아오는 쿼리와 Entity 목록을 받아오는 쿼리를 작성하였다
Select 때 영속성 컨텍스트에 Entity가 추가된다는 조건만 본다면,
두 개의 쿼리 모두 Select 쿼리인데 모두 영속성 컨텍스트에 포함될까?
public class JpaController {
    private final JpaService jpaService;

    @GetMapping("/example")
    public void simplified_example() {
        log.info("--- Tx 1:");
        jpaService.getAllEntityList();
        log.info("--- Tx 2:");
        jpaService.getAllIdList();
    }
}
public class JpaService {
private final TempRepository tempRepository;
@Transactional(readOnly = true)
public void getAllEntityList() {
Session session = em.unwrap(Session.class);
SessionImplementor si;
if(session instanceof SessionImplementor impl) {
si = impl;
} else {
si = em.unwrap(SessionImplementor.class);
}
var pc = si.getPersistenceContext();
List<Temp> entityList = tempRepository.getTempList();
log.info("Query Result Size: {}", entityList.size());
pc.getEntitiesByKey().forEach((k, e) -> {
log.info("Key: {}, Entity: {}", k, e);
});
}
@Transactional(readOnly = true)
public void getAllIdList() {
Session session = em.unwrap(Session.class);
SessionImplementor si;
if(session instanceof SessionImplementor impl) {
si = impl;
} else {
si = em.unwrap(SessionImplementor.class);
}
var pc = si.getPersistenceContext();
List<Long> idList = tempRepository.getIdList();
log.info("Query Result Size: {}", idList.size());
pc.getEntitiesByKey().forEach((k, e) -> {
log.info("Key: {}, Entity: {}", k, e);
});
}
}(본 예제는 학습을 위한 코드이며, 운영 코드에서 사용해서는 안 된다)
이번에도 로그를 통해서 확인해보려고 한다
각각의 트랜잭션에 앞서 작성한 쿼리를 통해 데이터를 가져오고,
그에 따라 영속성 컨텍스트에 포함되는지를 확인하고자 한다
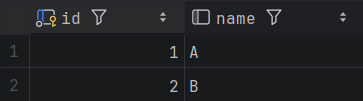
DB에는 이와 같은 단 2개의 데이터만 저장되어있는 상태이다
결과 로그를 확인해보면
test.demo.controller.JpaController       : --- Tx 1:
test.demo.service.JpaService             : Query Result Size: 2
test.demo.service.JpaService             : Key: EntityKey[test.demo.domain.entity.Temp with id '1'], Entity: test.demo.domain.entity.Temp@39869911
test.demo.service.JpaService             : Key: EntityKey[test.demo.domain.entity.Temp with id '2'], Entity: test.demo.domain.entity.Temp@6f83c563
test.demo.controller.JpaController       : --- Tx 2:
test.demo.service.JpaService             : Query Result Size: 2
위와 같이 나타나는 것을 볼 수 있다
객체로써 불러온 Entity는 영속성 컨텍스트에 추가되지만,
그렇지 않은 경우는 영속성 컨텍스트에 추가되지 않는다
이는 별도의 객체(DTO 등)로 변환해서 받는 Projection이나, Update 쿼리에도 동일하게 적용된다
8. 영속성 컨텍스트 관리 부재로 생기는 문제
영속성 컨텍스트에서 관리되지 않을 때 생기는 문제에는 무엇이 있을까?
첫 번째로, 객체 추적을 하지 않으니 트랜잭션 내부에 있더라도 Dirty Checking이 되지 않는다
Dirty Checking은 영속성 컨텍스트에서 객체 변화를 감지하며 발생하는 것인데,
영속성 컨텍스트 내에 객체가 존재하지 않으니 변화를 감지하는 것 역시 불가능하다
두 번째로, 캐시의 효과를 볼 수 없다
영속성 컨텍스트에 Entity가 등록되면,
그 관리 범위 내에선 동일 객체를 다시 조회하더라도 DB에 접근하지 않고 재사용할 수 있다
컨텍스트에서 관리하지 않는다면 DB 접근 빈도가 늘어난다
세 번째로, 캐시 불일치 문제가 생긴다
# 테스트 07. 영속성 컨텍스트 캐시 불일치 문제
public class JpaController {
    private final JpaService jpaService;

    @GetMapping("/example")
    public void simplified_example(
            @RequestHeader("X-Id") Long id,
            @RequestBody String name) {
        log.info("Update Name to {}", name);
        jpaService.updateName(id, "C");
    }
}
public class JpaService {
@Transactional
public void updateName(Long id, String name) {
Temp temp = tempRepository.get(id);
log.info("Selected Entity Object Name: {}", temp.getName());
tempRepository.updateName(id, name);
log.info("Updated Entity Object Name: {}", temp.getName());
String nameInCache = em.find(Temp.class, id).getName();
log.info("Entity Name in Cache: {}", nameInCache);
temp = tempRepository.get(id);
log.info("Re-selected Entity Name: {}", temp.getName());
}
}public class TempQueryDslRepositoryImpl implements TempQueryDslRepository {
private final JPAQueryFactory jpaQueryFactory;
@Override
public Temp get(Long id) {
return jpaQueryFactory.selectFrom(temp)
.where(temp.id.eq(id))
.fetchOne();
}
@Override
public void updateName(Long id, String name) {
jpaQueryFactory.update(temp)
.set(temp.name, name)
.where(temp.id.eq(id))
.execute();
}
}
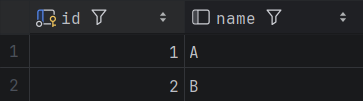
이번에도 아까와 동일한 DB 상태를 가지고, 위의 코드들로 실험을 해봤다
test.demo.controller.JpaController       : Update Name to C
test.demo.service.JpaService             : Selected Entity Object Name: A
test.demo.service.JpaService             : Updated Entity Object Name: A
test.demo.service.JpaService             : Entity Name in Cache: A
test.demo.service.JpaService             : Re-selected Entity Name: A
첫 번째 시도는 C로 바꾸도록 요청을 보냈고,
결과는 위와 같았다
객체의 값, 영속성 컨텍스트의 캐시가 변화되지 않았다
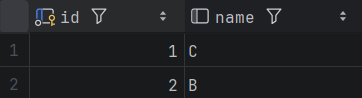
그리고 DB는 정상적으로 변경된 것으로 보아,
마지막 로그로 알 수 있듯, DB에서 값을 받아온 것이 아니라 캐시에서 불러온 것을 알 수 있다
test.demo.controller.JpaController       : Update Name to A
test.demo.service.JpaService             : Selected Entity Object Name: C
test.demo.service.JpaService             : Updated Entity Object Name: C
test.demo.service.JpaService             : Entity Name in Cache: C
test.demo.service.JpaService             : Re-selected Entity Name: C
두 번째 시도로 다시 A로 변환하도록 요청했다
이 때는 조회할 때 바뀐 C를 불러오는 것을 보아,
이전과는 다른 컨텍스트에 다시 데이터를 가져왔음을 알 수 있다
9. 영속성 컨텍스트의 구조
이번에는 영속성 컨텍스트의 구조가 어떻게 되어 있는지 알아보자
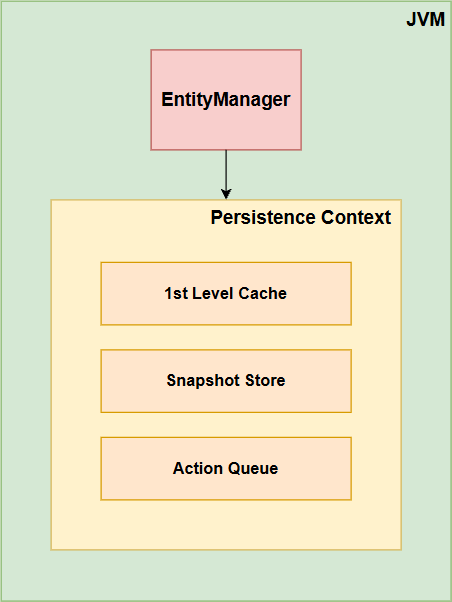
- 1st Level Cache: 1차 캐시. Entity Key - Entity 매핑으로 이루어진 Map 형태의 구조를 이룸
- Snapshot Store: 1차 캐시에 속한 Entity의 초기 로드 복사본을 가진다. Dirty Checking을 위한 추적
- Action Queue: Insert/Update/Delete의 SQL 대기열. 쿼리가 즉시 DB에 적용되지 않고 Flush 시점에 적용
10. 의도적인 영속성 컨텍스트 회피 전략
Update 쿼리를 통한 변화는 DB에 직접 반영되며 영속성 컨텍스트에 데이터가 추가되지 않는다
이는 JPA 설계에 있어 의도된 동작이라고 볼 수 있다
영속성 컨텍스트에서 Entity가 관리되지 않는 경우 여러 문제가 생길 수 있음을 봐왔는데,
그렇다면 JPA는 왜 이런 로직을 고수한 것일까?
답은,
영속성 컨텍스트의 객체 모델을 우회하여 데이터 집합의 연산을 수행하기 위한 효율적인 연산을 수행하기 위함이다
Scheduler나 Batch를 이용한 Bulk Update를 예로 들어보자
주기적으로, 1000개의 row(혹은 더 많은 데이터)에 대해 update를 진행하는 서비스가 있다
이때 1000개의 row에 대해 1st Level Cache, Snapshot Store를 관리한다고 하면?
이는 대량 데이터 처리 시 JVM의 메모리 사용량 증가와 GC 부담으로 이어질 수 있다
JPA는 이러한 문제에서 효율적인 대응을 할 수 있도록 영속성 컨텍스트를 우회할 수 있는 방법을 만들고,
그에 따른 Side Effect에 대한 책임은 개발자에게 돌리는 방식으로 문제를 해결했다
이는 편의 기능이 아니라,
정합성 리스크를 인지한 상태에서 선택해야 하는 고급 기능이다
이러한 부분이 우리가 데이터를 효율적으로 관리하기 위해 영속성 컨텍스트를 잘 이해해야 하는 이유이다
11. 2차 캐시
앞서 영속성 컨텍스트의 구조를 알아볼 때 1차 캐시라는 용어를 사용했다
그렇다면 2차 캐시는 어디에 존재할까?
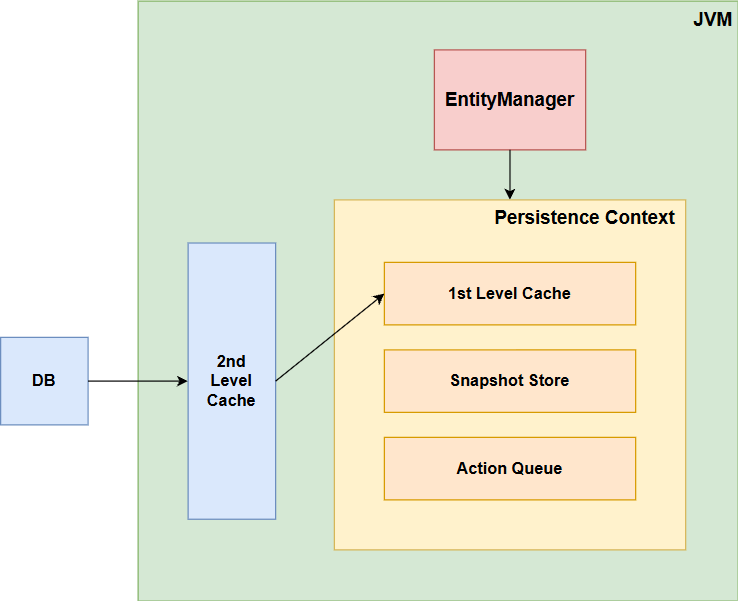
2차 캐시는 영속성 컨텍스트와 분리되어, JVM 레벨에서 공유되는 캐시 영역에 존재한다
즉, 하나의 트랜잭션 범위에 국한되는 1차 캐시와 달리,
2차 캐시는 서로 다른 트랜잭션 간에도 재사용될 수 있다.
이렇게 됐을 때 다음과 같은 시나리오를 고려해 볼 수 있었다
단일 인스턴스 환경(동일한 JVM)이라고 봤을 때,
Request 1: Select로 데이터 조회 (DB → 2차 캐시 → 1차 캐시 순으로 저장)
Request 2: Update로 데이터 수정 (DB로 직접 요청, 캐시 거치지 않음)
Request 3: Select로 데이터 조회 (2차 캐시에 데이터가 존재하므로 2차 캐시 → 1차 캐시 순으로 저장하고 그대로 사용)
이 경우 Request 2에서 DB의 데이터는 변경되었지만
2차 캐시는 이를 알지 못하고 기존 값을 반환할 가능성이 있어 보인다
다음과 같은 문제가 발생할 것이라는 가설을 세울 수 있다
2차 캐시는 영속성 컨텍스트를 우회한 Update 쿼리에 대해 정합성을 보장하지 못할 것이다.
이 가설을 검증하기 위해 또 한번 테스트를 진행하였다
# 테스트 08. 2차 캐시의 데이터 정합성 (단일 인스턴스)
public class JpaController {
    private final JpaService jpaService;

    private final EntityManagerFactory emf;

    @GetMapping("/check")
    public void checkMembership(
            @RequestHeader("X-Id") Long id) {
        jpaService.getMembership(id);
    }

    @PostMapping("/update")
    public void updateMembership() {
        LocalDateTime now = LocalDateTime.now();
        log.info("Now: {}", now);
        jpaService.updateMembership(now);
    }
}
public class JpaService {
private final MemberRepository memberRepository;
private final EntityManagerFactory emf;
public void getMembership(Long id) {
Member member = memberRepository.findById(id).orElse(null);
if(member == null) return;
String state = member.getState().toString();
LocalDateTime expiresAt = member.getExpiresPremiumAt();
var sf = emf.unwrap(org.hibernate.SessionFactory.class);
var s = sf.getStatistics();
log.info("2LC put={}, hit={}, miss={}",
s.getSecondLevelCachePutCount(),
s.getSecondLevelCacheHitCount(),
s.getSecondLevelCacheMissCount()
);
log.info("Member - id: {}, state: {}, expiresAt: {}", id, state, expiresAt);
}
@Transactional
public void updateMembership(LocalDateTime now) {
Long updatedRow = memberRepository.updateMembership(now);
log.info("Updated row: {}", updatedRow);
}
}@Getter
@Entity
@Cacheable
@Cache(usage = CacheConcurrencyStrategy.READ_WRITE)
public class Member {
@Id @GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;
private String name;
@Enumerated(EnumType.STRING)
private MemberState state;
private LocalDateTime expiresPremiumAt;
}
public enum MemberState {
NORMAL, PREMIUM
}public class MemberQueryDslRepositoryImpl implements MemberQueryDslRepository {
private final JPAQueryFactory jpaQueryFactory;
@Override
public Long updateMembership(LocalDateTime now) {
return jpaQueryFactory.update(member)
.set(member.state, MemberState.NORMAL)
.set(member.expiresPremiumAt, (LocalDateTime) null)
.where(member.expiresPremiumAt.loe(now))
.execute();
}
}

상황은 이렇다
Request 1(/check): 유저가 자신의 멤버십을 확인한다
Request 2(/update): Admin 또는 스케줄러가 만료 시간이 지난 멤버십을 해제시킨다
Request 3(/check): 유저가 자신의 멤버십을 다시 확인한다
과연 정합성이 보장될까?
# Request 1
test.demo.service.JpaService             : 2LC put=1, hit=0, miss=1
test.demo.service.JpaService             : Member - id: 1, state: PREMIUM, expiresAt: 2000-01-01T00:00

# Request 2
test.demo.controller.JpaController       : Now: 2026-01-25T20:11:26.501972
test.demo.service.JpaService             : Updated row: 1

# Request 3
test.demo.service.JpaService             : 2LC put=2, hit=0, miss=2
test.demo.service.JpaService             : Member - id: 1, state: NORMAL, expiresAt: null
결과로 알 수 있듯, 보장되었다
이때 첫 번째 요청을 통해 2차 캐시에 PUT이 일어난 것을 볼 수 있다
그리고 세 번째 요청에서 재차 Entity를 조회했을 때 역시 PUT이 일어난 것을 볼 수 있다
분명 첫 번째 요청에서 캐시에 저장이 됐다고 나오는데 왜 세 번째 캐시에서 다시 저장을 한다고 나올까?
혹시나 하는 마음에 요청을 더 추가해봤다
Request 4(/check): 유저가 자신의 멤버십을 다시 확인한다
Request 5(/check): 유저가 자신의 멤버십을 다시 확인한다
# Request 4
test.demo.service.JpaService             : 2LC put=2, hit=1, miss=2
test.demo.service.JpaService             : Member - id: 1, state: NORMAL, expiresAt: null

# Request 5
test.demo.service.JpaService             : 2LC put=2, hit=2, miss=2
test.demo.service.JpaService             : Member - id: 1, state: NORMAL, expiresAt: null
이 실험을 통해 다음 사실을 확인할 수 있었다
Hibernate는 Update 쿼리가 발생하면 해당 Entity의 2차 캐시를 신뢰할 수 없는 상태로 판단하고 캐시를 비운다
그렇다면 2차 캐시는 항상 안전할까?
또 하나의 시나리오를 테스트 해 보았다
# 테스트 09. 2차 캐시의 데이터 정합성 (다중 인스턴스)
다중 인스턴스 테스트를 어떻게 할지 고민하던 중, 다음과 같은 방법으로 검증할 수 있지 않을까 하는 생각이 들었다
"JVM을 거치지 않은 DB 쿼리 + JVM 2차 캐시를 통한 작동 확인을 한다면 다중 인스턴스 상황을 시뮬레이션 가능하겠다"
이 방법으로 테스트를 진행했다

DB는 앞선 테스트로 변해있는 상태로 두고,
update member set expires_premium_at = '2000-01-01 00:00:00', state = 'PREMIUM' where id = 1;
해당 SQL을 DB에 직접 적용하고 JVM 위에서의 변화를 확인해보려고 한다
순서는 아래와 같다
Request 1(/check): 유저의 멤버십을 확인한다
SQL: DB에 직접적인 쿼리를 적용한다 (다른 인스턴스에서 DB에 반영이 들어간 상황을 시뮬레이션)
Request 2(/check): 유저의 멤버십을 재차 확인한다
# Request 1
test.demo.service.JpaService             : 2LC put=1, hit=0, miss=1
test.demo.service.JpaService             : Member - id: 1, state: NORMAL, expiresAt: null

# SQL
update member set expires_premium_at = '2000-01-01 00:00:00', state = 'PREMIUM' where id = 1
11 ms 내 1 row이 영향을 받았습니다

# Request 2
test.demo.service.JpaService             : 2LC put=1, hit=1, miss=1
test.demo.service.JpaService             : Member - id: 1, state: NORMAL, expiresAt: null
인스턴스는 2차 캐시를 확인하고, DB를 확인하지 않은 채 데이터를 조회했다
DB는 이와 같이 변경된 상태인데도 말이다
이를 통해 2차 캐시는 항상 안전한 것이 아니며,
변경을 감지할 수 있는 범위 내에서만 정합성을 보장할 수 있는 캐시임을 알 수 있다
'탐구일지 > Java' 카테고리의 다른 글
| JVM GC는 어떻게 발전해왔는가? (0) | 2026.04.22 |
|---|---|
| JVM Tracing GC를 이해하려다 CPU Cache까지 간 이야기 (0) | 2026.03.29 |
| JVM은 어떻게 플랫폼 독립성과 성능을 동시에 잡았을까? (2) | 2026.03.26 |
| 영속성 컨텍스트(Persistence Context)의 이해와 활용 (1) (0) | 2026.01.20 |
| Blocking Vs. Non-Blocking I/O 선택은 어떻게 해야 하는가? (0) | 2026.01.12 |


